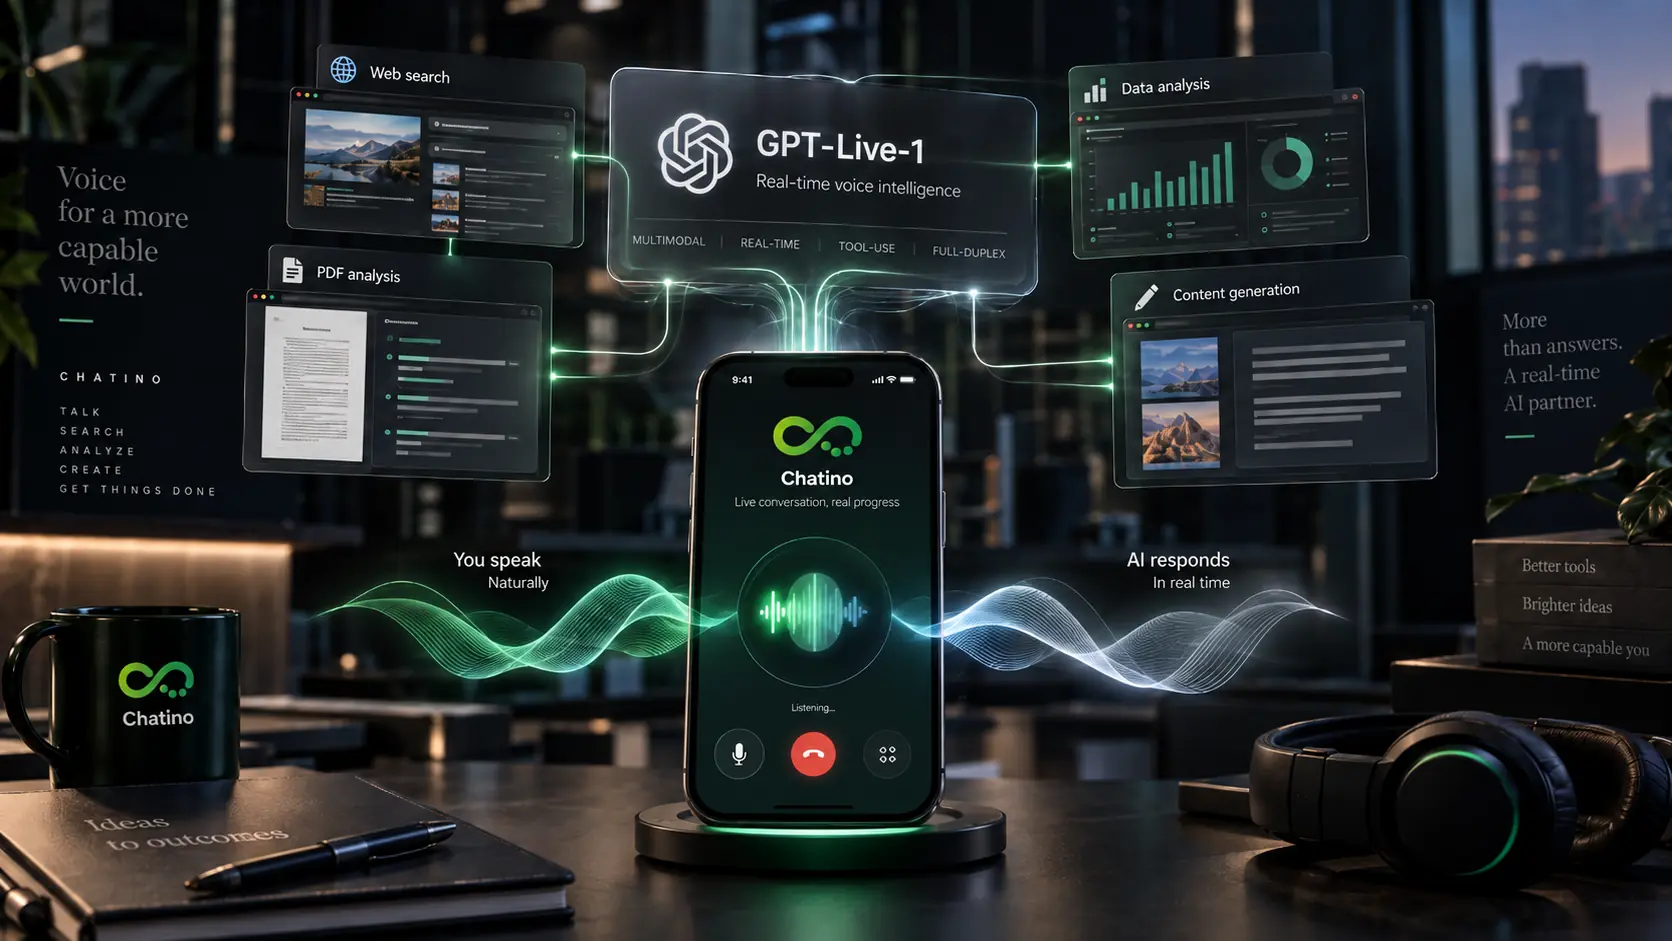
OpenAI در ۱۰ سپتامبر ۲۰۲۶، GPT-Live-1 را بهصورت عمومی در API عرضه کرد؛ مدلی که برای مکالمه صوتی بلادرنگ طراحی شده و تفاوت اصلی آن با بسیاری از Voice Botهای قدیمی در معماری Full-duplex است. یعنی مدل میتواند بهصورت همزمان گوش بدهد و صحبت کند، وقفهها را بهتر مدیریت کند و در حالی که یک Agent یا مدل دیگر در پسزمینه مشغول reasoning و استفاده از ابزارهاست، جریان مکالمه را حفظ کند.
این تغییر شاید در ظاهر فقط به طبیعیتر شدن مکالمه مربوط باشد، اما در عمل مسئله عمیقتر است. تا همین چند سال پیش، بیشتر سیستمهای صوتی هوش مصنوعی از یک زنجیره چندمرحلهای استفاده میکردند: ابتدا صدای کاربر به متن تبدیل میشد، بعد یک مدل زبانی پاسخ متنی تولید میکرد و در نهایت پاسخ دوباره به صدا تبدیل میشد. این ساختار کار میکرد، اما اغلب باعث تأخیر، مکالمه خشک و مدیریت ضعیف وقفهها میشد. GPT-Live-1 تلاش میکند این فاصله را کمتر کند و Voice را از یک لایه جانبی به بخشی اصلی از تجربه هوش مصنوعی تبدیل کند.
GPT-Live-1 چیست؟
GPT-Live-1 نسل جدید مدلهای صوتی OpenAI برای تعامل طبیعیتر میان انسان و هوش مصنوعی است. این مدل Full-duplex است؛ یعنی برخلاف سیستمهایی که منتظر میمانند کاربر کاملاً صحبتش را تمام کند، میتواند جریان صوت را بهصورت پیوسته دریافت کند و همان لحظه تصمیم بگیرد که پاسخ دهد، صبر کند یا اجازه دهد کاربر حرفش را ادامه دهد. OpenAI همچنین این مدل را بهگونهای طراحی کرده که بتواند مکالمه را مدیریت کند و کارهای پیچیدهتر را به مدلها، ابزارها یا Agentهای پشت صحنه واگذار کند.
GPT-Live-1 پیش از عرضه API، از ژوئیه ۲۰۲۶ وارد ChatGPT Voice شده بود. OpenAI نسخه کامل را برای کاربران پولی و GPT-Live-1 mini را برای کاربران Free در نظر گرفته است. هر دو مدل میتوانند همزمان گوش بدهند و صحبت کنند، اما نسخه کامل برای تجربه صوتی پیشرفتهتر و تواناییهای گستردهتر طراحی شده است.
Full-duplex دقیقاً چه تغییری در مکالمه ایجاد میکند؟
اگر با یک انسان صحبت کنید، مکالمه کاملاً نوبتی و مکانیکی نیست. ممکن است وسط حرف طرف مقابل بگویید «آره»، مکث کوتاهی داشته باشید، جملهتان را اصلاح کنید یا قبل از اینکه طرف مقابل کاملاً ساکت شود واکنش نشان دهید. بیشتر Voice Botهای قدیمی در همین نقطه مشکل داشتند، چون باید تشخیص میدادند که آیا کاربر واقعاً صحبتش را تمام کرده یا فقط چند لحظه مکث کرده است.
GPT-Live-1 برای چنین موقعیتهایی طراحی شده است. مدل میتواند pause، interruption و acknowledgementهای کوتاه را بهتر تشخیص دهد و براساس جریان مکالمه تصمیم بگیرد که پاسخ دهد یا همچنان گوش کند. این قابلیت باعث میشود گفتگو کمتر شبیه تبادل پیامهای صوتی جداگانه و بیشتر شبیه یک مکالمه زنده باشد.
تفاوت مهم دیگر این است که Full-duplex فقط به سرعت مربوط نیست. هدف این نیست که مدل چند میلیثانیه سریعتر جواب بدهد؛ هدف این است که ساختار Turn-taking طبیعیتر شود. اگر این بخش درست کار کند، کاربر کمتر مجبور است منتظر بماند، جملههایش را به شکل مصنوعی کوتاه کند یا هر بار منتظر علامت پایان صحبت سیستم بماند.
تفاوت GPT-Live-1 با Voice Botهای سنتی
| ویژگی | Voice Bot سنتی | GPT-Live-1 |
|---|---|---|
| معماری اصلی | Speech-to-Text → LLM → Text-to-Speech | مدل صوتی Full-duplex |
| گوش دادن و صحبت همزمان | معمولاً ندارد | دارد |
| مدیریت interruption | محدود یا پرخطا | طبیعیتر |
| تشخیص مکثهای کوتاه | معمولاً وابسته به Turn Detection ساده | تطبیقیتر |
| ادامه گفتگو هنگام انجام Task | معمولاً مکالمه متوقف میشود | میتواند گفتگو را حفظ کند |
| اتصال به Agent و ابزارها | نیازمند معماری جداگانه | برای delegation طراحی شده |
| کنترل لحن و سرعت | محدودتر | قابل کنترل از طریق Prompt |
| پشتیبانی ارتباطی | وابسته به سرویس واسط | WebRTC، WebSocket و Telephony |
تفاوت اصلی این دو معماری فقط در تعداد اجزای فنی نیست. Voice Bot سنتی بیشتر شبیه یک زنجیره پردازش بود، اما GPT-Live-1 تلاش میکند خود مکالمه را بهعنوان یک فرایند زنده درک کند. همین موضوع باعث میشود Voice Agentها بتوانند نقش فعالتری در Workflowهای واقعی داشته باشند.
GPT-Live-1 چگونه با Agentها کار میکند؟
یکی از مهمترین ویژگیهای GPT-Live-1 این است که قرار نیست همه reasoning سنگین را خودش انجام دهد. OpenAI این مدل را بهعنوان لایه مکالمهای طراحی کرده که میتواند کار پیچیدهتر را به یک مدل یا Agent دیگر بسپارد و در همین فاصله ارتباط با کاربر را حفظ کند. در API، توسعهدهنده میتواند از Responses delegation با مدلهای OpenAI استفاده کند یا Backend خودش را به GPT-Live-1 متصل کند.
فرض کنید کاربر در یک مکالمه صوتی میگوید: «پروازهای فردا رو پیدا کن، فقط گزینههایی که صبح میرسن بررسی کن و ارزونترینش رو بهم بگو.» در معماری سنتی، Voice Bot معمولاً باید تا پایان جستجو منتظر بماند یا مکالمه را متوقف کند. در معماری جدید، لایه صوتی میتواند گفتوگو را ادامه دهد، سؤال تکمیلی بپرسد یا وضعیت کار را به کاربر اعلام کند، در حالی که Agent پشت صحنه جستجو و مقایسه را انجام میدهد.
همین الگو برای قابلیتهایی مانند جستجوی وب با هوش مصنوعی نیز اهمیت دارد. وقتی Voice به Search متصل شود، کاربر بهجای تایپ کردن چند Query و بررسی جداگانه نتایج میتواند مسئله را به زبان طبیعی توضیح دهد و پاسخ نهایی را در قالب یک مکالمه دریافت کند.
مدل صوتی جدید فقط برای حرف زدن نیست
نکتهای که GPT-Live-1 را از یک فناوری صرفاً سرگرمکننده جدا میکند این است که Voice میتواند به ورودی اصلی سایر قابلیتهای هوش مصنوعی تبدیل شود. اگر سیستم فقط حرف کاربر را بشنود و پاسخ صوتی بدهد، هنوز بخش زیادی از ظرفیت آن استفاده نشده است. ارزش واقعی زمانی ایجاد میشود که مکالمه صوتی به ابزارها، فایلها و Workflowهای دیگر وصل شود.
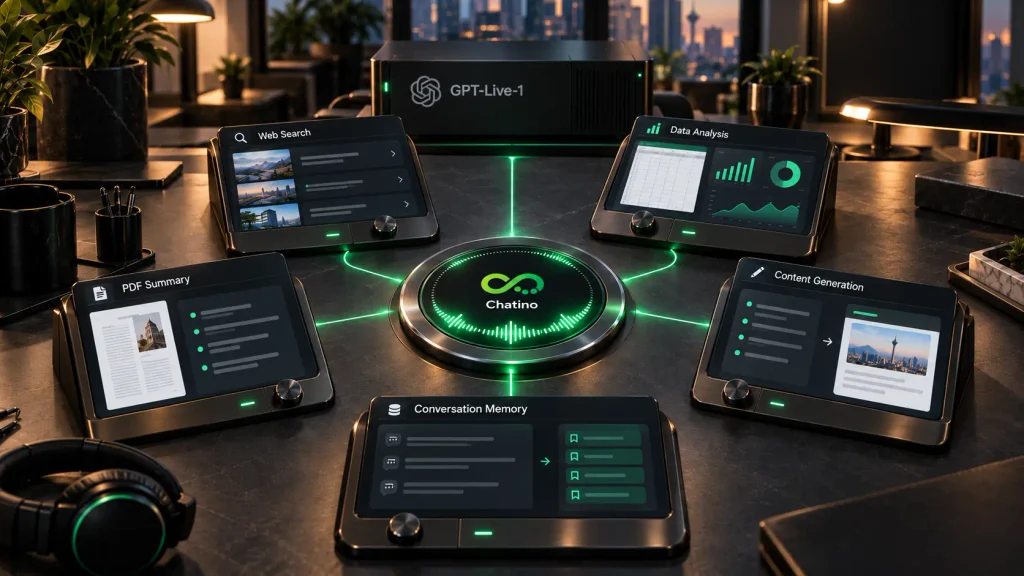
این همان نقطهای است که قابلیتهای مختلف چتینو میتوانند در کنار Voice معنا پیدا کنند. کاربر میتواند با گفتگوی صوتی با هوش مصنوعی درخواستش را مطرح کند، سپس از جستجوی وب برای اطلاعات بهروز استفاده شود، یک فایل با خلاصه PDF بررسی شود، دادهها با قابلیت تحلیل داده پردازش شوند یا نتیجه در قالب یک متن با قابلیت تولید محتوا آماده شود. در چنین تجربهای Voice دیگر یک قابلیت مستقل نیست؛ بیشتر شبیه درِ ورودی طبیعی برای مجموعهای از ابزارهای هوش مصنوعی است.
مثلاً تصور کنید یک کاربر فایل گزارش فروش ماهانه را در اختیار سیستم گذاشته و بهجای تایپ کردن میگوید: «ببین افت فروش بیشتر مربوط به کدوم دسته محصول بوده و بعد یه خلاصه مدیریتی کوتاه برام آماده کن.» در این سناریو صدا فقط روش ارسال دستور است؛ ارزش اصلی از ترکیب گفتگوی صوتی، تحلیل فایل و تولید خروجی شکل میگیرد.
وقفه، مکث و تأییدهای کوتاه چرا اینقدر مهماند؟
بخش بزرگی از طبیعی بودن مکالمه از رفتارهایی میآید که معمولاً در معرفی مدلهای AI کمتر درباره آنها صحبت میشود. انسانها هنگام گفتگو دائماً از نشانههای کوچک استفاده میکنند: «آهان»، «خب»، «باشه»، مکث کوتاه یا قطع کردن محترمانه صحبت طرف مقابل. اگر سیستم هرکدام از این رفتارها را بهعنوان پایان قطعی جمله تفسیر کند، مکالمه خیلی زود مصنوعی میشود.
GPT-Live-1 برای مدیریت همین جزئیات بهینه شده است. OpenAI میگوید مدل میتواند interruptionها، pauseها و brief acknowledgements را در جریان مکالمه تشخیص دهد. این ویژگی از نظر تجربه کاربری شاید مهمتر از افزایش ساده کیفیت صدای تولیدشده باشد، چون باعث میشود کاربر مجبور نباشد نحوه صحبت طبیعی خودش را با محدودیت سیستم تطبیق دهد.
کنترل لحن، سرعت و شخصیت Voice Agent
OpenAI در GPT-Live-1 کنترل بیشتری روی نحوه صحبت Agent قرار داده است. توسعهدهنده میتواند از طریق Prompt روی tone، pace و conversational style اثر بگذارد و گزینههای صوتی بیشتری نیز برای ساخت تجربههای متفاوت در اختیار داشته باشد.
اهمیت این موضوع فقط زیبایی صدا نیست. یک دستیار آموزشی، Agent فروش، سیستم پشتیبانی مشتری و دستیار شخصی نباید دقیقاً با یک لحن و ریتم حرف بزنند. در یک سرویس آموزشی ممکن است سرعت پایینتر و توضیح صبورانه مناسبتر باشد، در حالی که یک Agent پشتیبانی باید سریع، روشن و مستقیم صحبت کند. شخصیسازی رفتار صوتی باعث میشود Voice Agent بیشتر با نقش واقعی خود هماهنگ شود.
GPT-Live-1 برای چه کاربردهایی مناسب است؟
یکی از کاربردهای واضح GPT-Live-1 ساخت دستیارهای صوتی شخصی است؛ سیستمهایی که کاربر بتواند هنگام رانندگی، کار کردن یا زمانی که امکان تایپ ندارد با آنها تعامل کند. اما کاربردهای جدیتر در محیطهای کاری دیده میشوند، بهخصوص در پشتیبانی مشتری، فروش تلفنی و Agentهایی که باید علاوه بر مکالمه، Task واقعی هم انجام دهند.
در یک مرکز پشتیبانی، Agent صوتی میتواند صحبت مشتری را بشنود، اطلاعات حساب را از ابزار مربوطه دریافت کند و بدون اینکه مکالمه قطع شود پاسخ مناسب ارائه دهد. در فروش، سیستم میتواند براساس سؤال مشتری اطلاعات محصول را بررسی کند و پاسخ شخصیسازیشده بدهد. در محیطهای حرفهایتر نیز Voice میتواند لایه تعامل با ابزارهایی مثل تحلیل داده، Search یا مدیریت فایل باشد.
این رویکرد برای چتینو نیز اهمیت دارد، چون قابلیتهایی مانند جستجوی وب، تحلیل داده، خلاصه PDF، تولید محتوا، حافظه گفتگو و گفتگوی صوتی زمانی ارزش بیشتری پیدا میکنند که بهجای مجموعهای از ابزارهای جداگانه، در یک تجربه یکپارچه قابل استفاده باشند.
قیمت GPT-Live-1 چقدر است؟
GPT-Live-1 در API با قیمت ۰.۰۵ دلار بهازای هر دقیقه Voice Session عرضه شده و محاسبه هزینه بهصورت ثانیهای انجام میشود. هزینه مدل Backend، Search، ابزارها و سایر پردازشهایی که در طول مکالمه انجام میشوند جداگانه محاسبه خواهند شد.
این نکته در طراحی Voice Agentهای واقعی مهم است. هزینه یک سیستم صوتی فقط به مدت تماس وابسته نیست؛ اگر Agent در طول مکالمه مرتباً مدل reasoning سنگین، Web Search یا ابزارهای دیگر را فراخوانی کند، هزینه نهایی بالاتر خواهد رفت. بنابراین انتخاب درست مدل Backend و مدیریت زمان استفاده از ابزارها میتواند روی اقتصاد محصول تأثیر زیادی داشته باشد.
GPT-Live-1 در برابر نسل قبلی Realtime
OpenAI پیش از GPT-Live-1 نیز فناوریهای Realtime برای تعامل صوتی ارائه کرده بود، اما نسل GPT-Live تمرکز بیشتری روی Full-duplex conversation، مدیریت Turn-taking و delegation دارد. هدف این است که لایه Voice مجبور نباشد خودش همه کارها را انجام دهد؛ بلکه بتواند مکالمه را مدیریت کند و در مواقع لازم از مدلهای قدرتمندتر یا ابزارهای تخصصی کمک بگیرد.
این معماری از نظر محصول منطقیتر است. برای پاسخ دادن به یک سؤال ساده نیازی نیست یک مدل بسیار سنگین فعال شود، اما اگر کاربر ناگهان یک تحقیق پیچیده یا تحلیل چندمرحلهای درخواست کند، سیستم میتواند همان Task را به Backend مناسب بسپارد. نتیجه این است که تجربه صوتی میتواند سریع بماند بدون اینکه توانایی انجام کارهای دشوار از بین برود.
GPT-Live-1 چه معنایی برای آینده چتباتها دارد؟
تا امروز، رابط غالب تعامل با هوش مصنوعی یک کادر متن بوده است. کاربر مینویسد، مدل پاسخ میدهد و مکالمه مرحله به مرحله جلو میرود. Voice میتواند این الگو را تغییر دهد، اما فقط زمانی که از تبدیل صدا به متن فراتر برود.
اگر یک مدل بتواند همزمان گوش کند و صحبت کند، وقفهها را بفهمد، Context مکالمه را نگه دارد، ابزار فراخوانی کند و Taskهای پیچیده را در پسزمینه جلو ببرد، Voice دیگر یک ویژگی جانبی نیست. در چنین شرایطی میتواند به رابط اصلی تعامل با Agentها تبدیل شود.
این مسئله برای کارهایی مثل Search، کار با فایل و تحلیل داده اهمیت زیادی دارد. کاربر لزوماً نمیخواهد بداند پشت صحنه کدام ابزار اجرا شده یا کدام مدل پاسخ را پردازش کرده است. او فقط میخواهد بگوید: «این PDF رو بررسی کن و سه نکته مهمش رو بهم توضیح بده» یا «فایل فروش رو تحلیل کن و بگو چرا این ماه افت کردیم». اگر سیستم بتواند این درخواست را از طریق Voice دریافت کند و Workflow مناسب را پشت صحنه اجرا کند، تجربه استفاده از AI بسیار طبیعیتر میشود.
گفتگوی صوتی در چتینو؛ وقتی Voice به قابلیتهای دیگر وصل میشود
در چتینو، گفتگوی صوتی میتواند فقط یک روش دیگر برای پرسیدن سؤال نباشد. ارزش اصلی زمانی ایجاد میشود که Voice در کنار سایر قابلیتهای پلتفرم قرار بگیرد و کاربر بتواند بدون تغییر مداوم ابزار، مسئله را در قالب یک مکالمه جلو ببرد.
برای نمونه، کاربر میتواند از طریق Voice سؤالش را مطرح کند، از جستجوی وب برای دریافت اطلاعات تازه استفاده کند، درباره یک فایل با خلاصه PDF گفتگو کند یا نتیجه یک تحلیل داده را به زبان ساده بشنود. اگر مکالمه با حافظه گفتگو ترکیب شود، سیستم همچنین میتواند Context تعاملهای قبلی را بهتر در تجربه کلی حفظ کند.
این همان مسیری است که Voice Agentهای نسل جدید به سمت آن حرکت میکنند: صدا دیگر مقصد نهایی نیست، بلکه رابطی برای دسترسی سادهتر به مجموعهای از قابلیتهای هوش مصنوعی است.
محدودیتهای GPT-Live-1
با وجود پیشرفتهای قابل توجه، GPT-Live-1 هنوز تجربهای کاملاً بدون محدودیت نیست. OpenAI اعلام کرده مدل برای تعدادی از زبانهای پرکاربرد بهینه شده، اما در بعضی زبانها ممکن است accent غیرطبیعی یا ضعفهایی در fluency دیده شود. این موضوع برای زبانهایی که داده صوتی کمتری دارند میتواند محسوستر باشد.
همچنین GPT-Live در زمان عرضه از Voice همراه با Video یا Screen Sharing در ChatGPT پشتیبانی نمیکند. OpenAI اعلام کرده روی اضافه کردن این قابلیتها کار میکند، اما در وضعیت فعلی کاربران برای چنین سناریوهایی باید از تجربههای قدیمیتر Voice استفاده کنند.
محدودیت دیگر به ماهیت خود Voice Agentها مربوط میشود. هرچه مدل اختیار بیشتری برای اجرای Task داشته باشد، طراحی Guardrail، مدیریت اشتباهات و کنترل دسترسی به ابزارها اهمیت بیشتری پیدا میکند. طبیعیتر شدن مکالمه نباید باعث شود کاربر فراموش کند که پشت این تجربه همچنان یک سیستم هوش مصنوعی قرار دارد.
جمعبندی
GPT-Live-1 فقط یک مدل صوتی با صدای طبیعیتر نیست. اهمیت اصلی آن در تغییر معماری تعامل با هوش مصنوعی است. Full-duplex بودن، مدیریت طبیعیتر interruptionها و امکان delegation به Agentها و ابزارهای Backend باعث میشود Voice از یک قابلیت جانبی به بخشی جدی از Workflow هوش مصنوعی تبدیل شود.
در این مدل جدید، کاربر لازم نیست منتظر پایان کامل هر مرحله بماند. میتواند صحبت کند، سؤال تکمیلی بپرسد و مکالمه را ادامه دهد، در حالی که سیستم پشت صحنه Search، reasoning یا ابزارهای دیگر را اجرا میکند. همین ویژگی میتواند Voice Agentها را برای پشتیبانی، فروش، دستیارهای شخصی و پروژههای حرفهای بسیار کاربردیتر کند.
برای چتینو نیز این مسیر اهمیت ویژهای دارد. وقتی گفتگوی صوتی در کنار قابلیتهایی مثل جستجوی وب، تحلیل داده، خلاصه PDF، تولید محتوا و حافظه گفتگو قرار بگیرد، Voice دیگر صرفاً یک روش متفاوت برای چت کردن نیست؛ به رابطی طبیعی برای استفاده از مجموعهای از تواناییهای هوش مصنوعی تبدیل میشود.
برای جزئیات فنی و اطلاعات رسمی مدل میتوانید معرفی GPT-Live-1 در وبسایت OpenAI را مطالعه کنید.
سوالات متداول
GPT-Live-1 چیست؟
GPT-Live-1 مدل صوتی Full-duplex شرکت OpenAI است که میتواند بهصورت همزمان گوش بدهد و صحبت کند، interruptionها را مدیریت کند و کارهای پیچیدهتر را به مدلها یا Agentهای Backend واگذار کند.
تفاوت GPT-Live-1 با Voice Botهای معمولی چیست؟
بیشتر Voice Botهای سنتی از زنجیره Speech-to-Text، مدل متنی و Text-to-Speech استفاده میکنند. GPT-Live-1 برای تعامل صوتی پیوسته طراحی شده و میتواند Turn-taking، مکث و قطع کردن صحبت را طبیعیتر مدیریت کند.
آیا GPT-Live-1 میتواند هنگام مکالمه از ابزارها و Agentها استفاده کند؟
بله. GPT-Live-1 میتواند لایه مکالمه را مدیریت کند و reasoning یا اجرای ابزارها را به مدل یا Agent Backend بسپارد؛ در حالی که گفتگو با کاربر همچنان ادامه پیدا میکند.